這是一批約一千本的舊書,是一家珍本書商的存貨,不久前被神秘買家訂下。為追蹤這個買家的身分和用途,美國科技媒體404 Media利用AirTag追蹤器展開了調查。
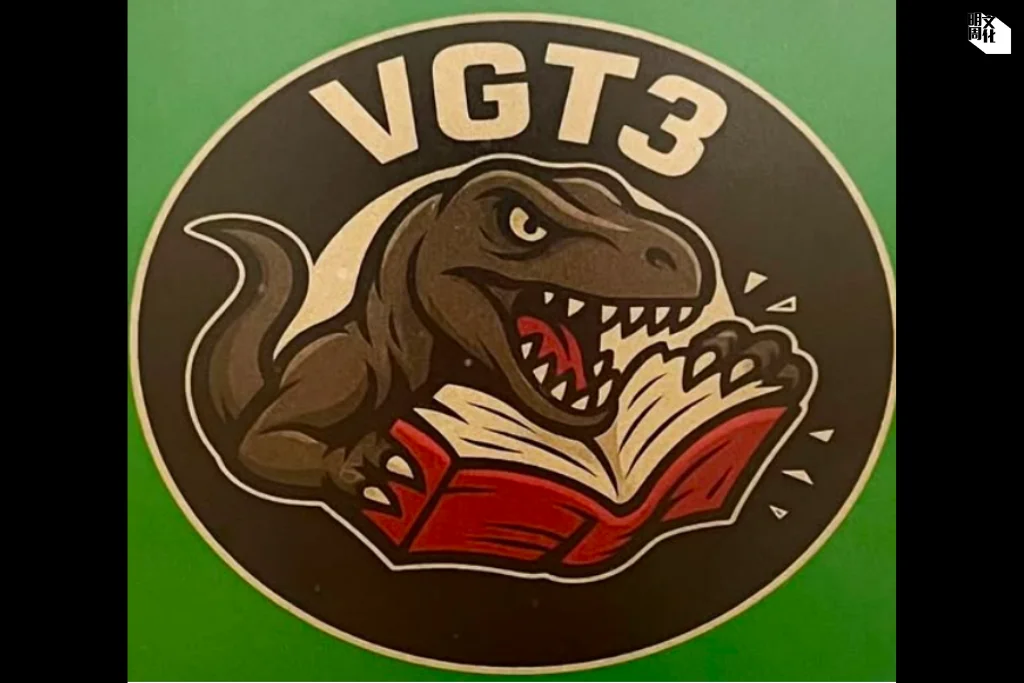
追蹤器紀錄顯示,這批書從加州出發,輾轉多個城市,最終停在拉斯維加斯的一處倉庫。這是美國巨頭公司亞馬遜的倉庫,內部代號「VGT3」。據亞馬遜員工描述,這是一個專門處理書籍掃描的設施,標誌是一隻手持書本的霸王龍。在這裏,運來的書籍會先拆除裝訂,讓書頁通過高速掃描設備,再逐頁掃描內容,完成後便將散頁丟棄或回收。
這套流程,與建立AI大型數據庫的做法幾乎完全吻合。不過,亞馬遜並未公開確認涉及的書籍數量、作業據點數目,也沒有證實拉斯維加斯的資料是否用於訓練某一款特定AI模型,只表示購書是「為了改善我們的產品」。
⚡ 文章目錄
去向不明的大量舊書
書商向404 Media表示,近年有些大宗訂單的內容十分駁雜,似乎不太在意書籍的價格、品相、主題或市場需求,但出版日期均在數年甚至數十年前。
今年8月,《衛報》採訪了澳洲多家二手書商,發現亦有買家一次購入幾十本書,選書卻毫無主題可言:有一九七〇年代的土壤力學手冊、二〇一〇年出版的新西蘭腳踏車運動書、上世紀澳洲詩集,甚至墨爾本的地方史。其中一本已在書架上乏人問津二十年、售價僅9澳元的詩集,也在選購之列。
如果是求轉賣的書商,大宗收購通常要衡量需求與利潤;但這些「異常」訂單的目的顯然並非如此。如果是要餵養AI訓練資料,就説得通了:一本書能賣多少錢不重要,重要的是能否提供資料庫裏缺失的文字。這些被收購的書,對於書商而言是庫存壓力,對AI而言卻是極具「營養價值」的教科書。
AI也在尋找沒有被AI「污染」的語言
這牽涉一個業界近年反覆討論的問題:「模型崩潰」(model collapse),即當AI大模型不斷用AI生成的內容訓練下一代模型,其品質可能隨之遞減,如同不斷複印複印件,畫面也會愈來愈模糊。據Epoch AI估算,可用於訓練的優質公開人類文本約有300萬億token,按趨勢可能在二〇二六至二〇三二年間被充分使用。
《福布斯》今年8月的報導亦指出,如今整個互聯網的內容愈來愈像AI寫出來的東西,於是AI產業開始回頭尋找那些AI出現以前的人類智慧。
這也是為甚麼由人類創作、未經AI污染的早期紙本書,會被AI公司盯上。那些出版於「AI元年」二〇二二年之前的書,很多內容從未被數碼化,使得它們成為AI公司眼中的「上等飼料」。
出版業的夕陽還是曙光
這形成了一個產業鏈:AI的發展讓網絡上充斥着由AI生成的內容,而AI公司為了訓練出更像人類的模型,必須大量「閱讀」紙本書。曾被視為夕陽產業的書籍及出版業,又因此收到訂單,只是訂單另一端,不再是想讀書的讀者,而是嗷嗷待哺的AI。
出版業也在重新思考自己的角色。大型出版社如企鵝蘭登書屋、麥米倫、哈珀科林斯(HarperCollins)等,都在尋找適當的應對方案。企鵝蘭登書屋已在新書和再版書的版權頁加入聲明,禁止未經許可將作品用於AI訓練,並公開主張此類使用屬於侵權。
但出版業也並非一味拒絕AI,哈珀科林斯的做法是選擇授權,與AI公司達成協議,讓部分非虛構舊書在作者自願加入的情況下進入訓練數據,並支付費用。